RAG精度を最大化するチャンク分割の技術的勘所:社内ドキュメント活用の最適解
「社内規定ボットを作ったが、回答が的外れで使い物にならない」——。多くの情報システム部門が直面するこの課題の正体は、LLM(大規模言語モデル)の性能不足ではなく、データの「切り出し方(チャンク分割)」にあります。膨大な社内ドキュメントをAIが検索しやすいサイズに最適化するチャンキング戦略は、RAG(検索拡張生成)の精度を左右する最重要工程です。本記事では、支援現場での実例をもとに、情報システム部門の負担を激減させるための実践的な技術的勘所を解説します。
1. なぜ「固定長分割」では問い合わせが減らないのか
初期のRAG構築でよくある失敗は、文字数だけで機械的にデータを区切る「固定長分割」の採用です。例えば、300文字ごとに分割した場合、重要な規定の文章が途中で泣き別れになり、AIが文脈を正しく理解できなくなります。実際のご支援では、この「文脈の断絶」が原因でハルシネーション(もっともらしい嘘)が発生し、結局ユーザーが情報システム部門に電話で確認するという本末転倒な事態を数多く目にしてきました。
上図の通り、分割手法を高度化するだけで精度は劇的に向上します。現場でよくあるのは、「第○条」という見出し情報をチャンクごとに保持させる工夫です。これにより、どの部分を引用した回答なのかが明確になり、ユーザーの信頼を獲得できます。
2. 階層構造を維持する「セマンティック・チャンキング」の実装
社内規定やマニュアルは、大項目・中項目・小項目の階層構造を持っています。この構造を無視してベクトル化しても、検索ヒット率は上がりません。私たちの自社EC構築・成長支援の現場でも、商品マニュアルの検索性を高めるために、HTMLやMarkdownのタグを利用した「構造化分割」を推奨しています。
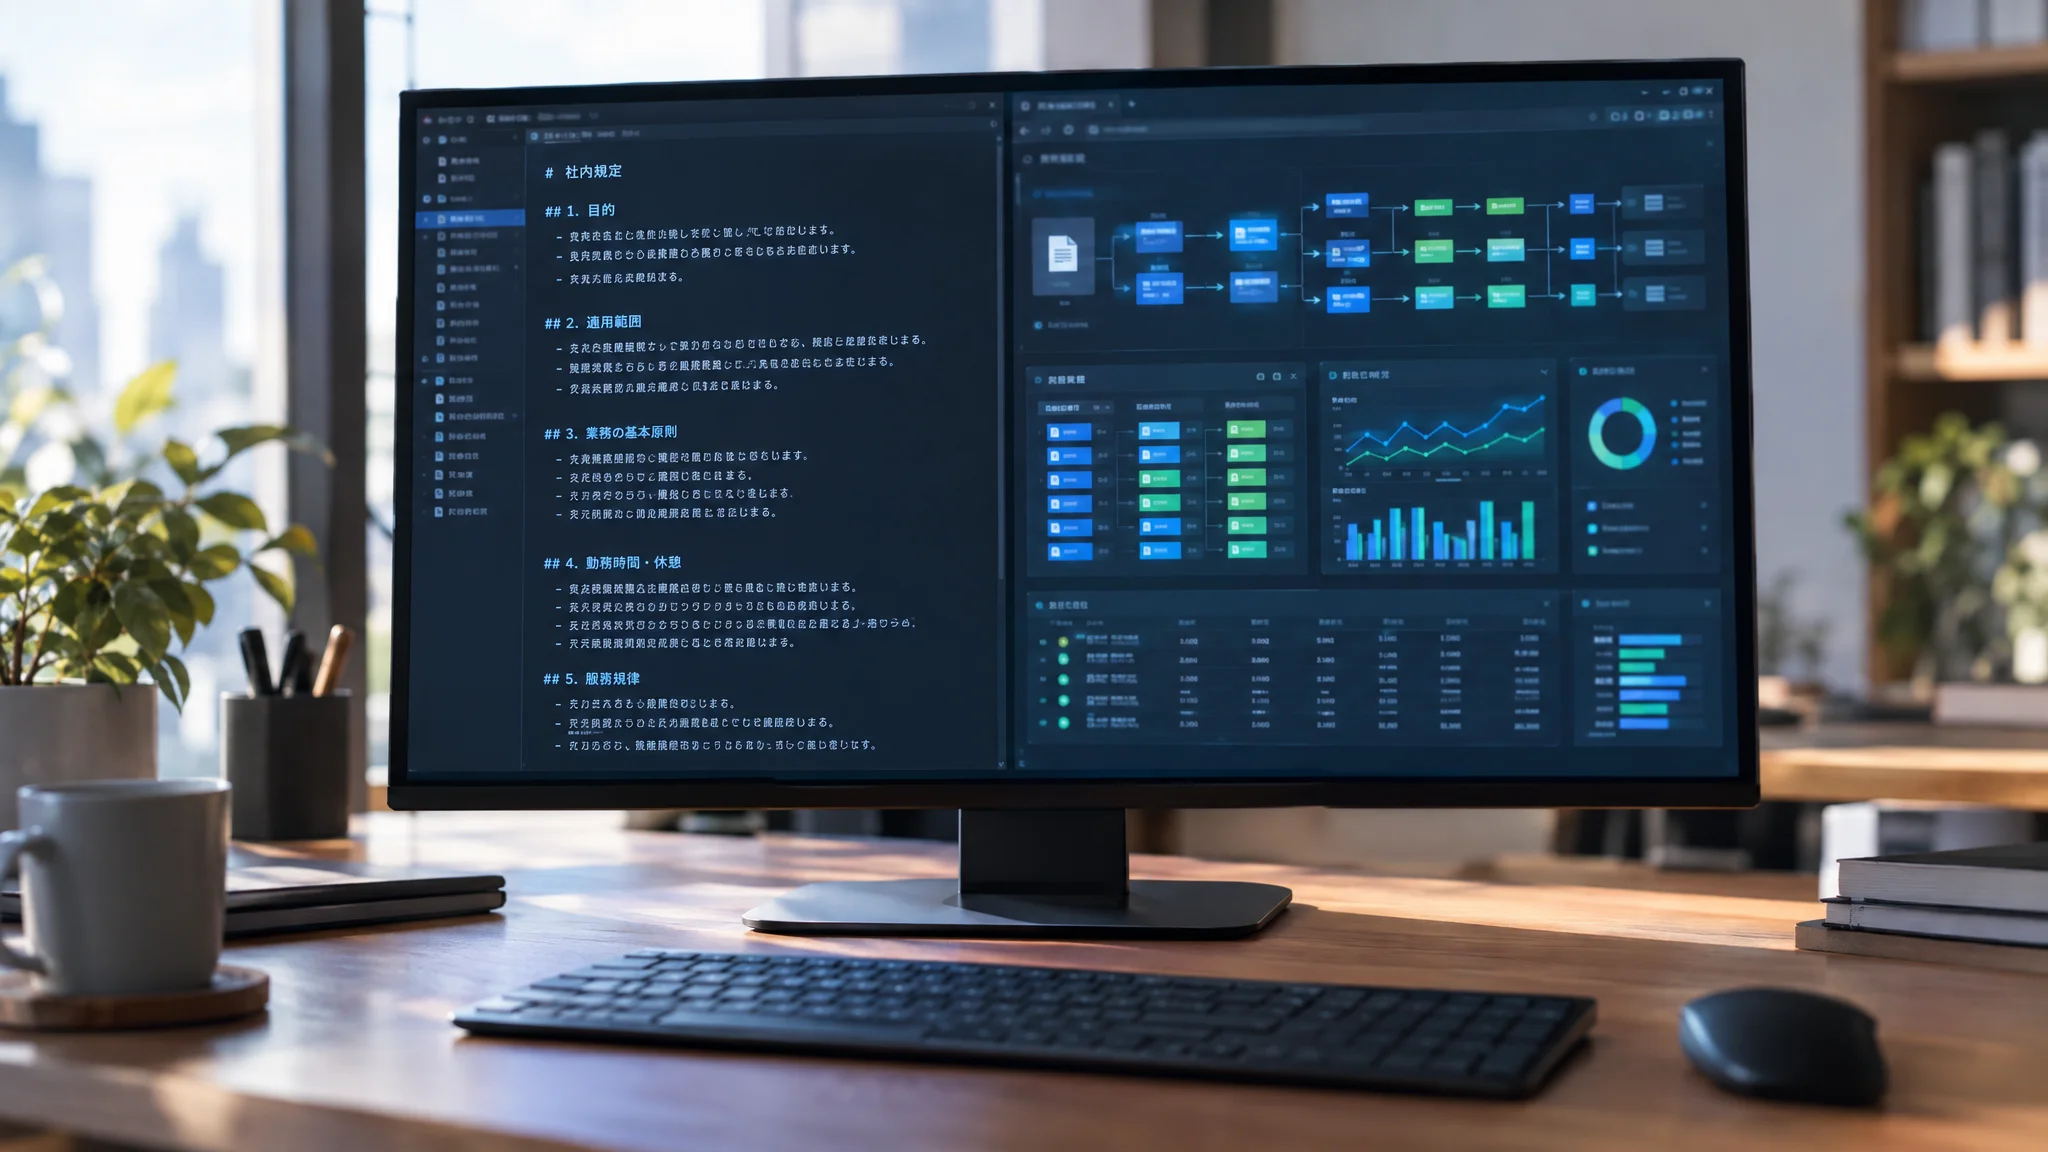
具体的には、再帰的文字分割(RecursiveCharacterTextSplitter)を用いつつ、セパレーターとして「\n\n」「\n」「。」「、」の優先順位を定義します。これにより、意味のまとまりを維持したまま、埋め込みモデルのトークン制限内に収めることが可能になります。支援現場では、この設定を1ミリ単位で調整するような泥臭い作業こそが、最終的な「問い合わせ削減」という成果に直結すると確信しています。
3. 情報システム部門の工数を8割削減するメタデータ付与の自動化
精度の高いRAGには、チャンクごとの「メタデータ(属性情報)」が不可欠です。「これは2024年度の規定か?」「どの部署向けの資料か?」といった情報を付与することで、検索範囲を絞り込み、精度を極限まで高められます。しかし、これを手動で行うのは情報システム部門にとって膨大な負担です。
そこで有効なのが、LLM自体を使ってメタデータを自動生成する「セルフメタデータ・タグ付け」です。チャンクを投入する際に、その要約やキーワードをAIに抽出させ、ベクトルデータベースのペイロードに格納します。実際のご支援では、この自動化により、データメンテナンスにかかる工数を約80%削減できた事例もあります。情報システム部門が「嵐のような問い合わせ」から解放されるためには、こうした「AIを作るためのAI活用」という視点が欠かせません。
よくある質問
- Q. チャンクサイズはどのくらいが適切ですか?
- A. 一般的には512〜1024トークンが推奨されますが、日本語の場合は文字数で300〜600文字程度からテストを始めるのが定石です。文脈を重視する場合は、前後のチャンクを一部重複させる「オーバーラップ」を10〜20%設定するのが現場での鉄則です。
- Q. PDFの表組みがうまく読み込めないのですが?
- A. PDFの表は構造が壊れやすいため、Markdown形式に変換してからチャンク分割することをお勧めします。複雑な表の場合は、表全体を一つのチャンクとし、その内容を要約したテキストをメタデータとして付与する手法が最も安定します。
- Q. 既存のFAQがある場合、どう分割すべきですか?
- A. FAQは「1問1答」の単位が既に一つの意味を成しているため、無理に分割せず、1つのQ&Aを1チャンクとして扱うのがベストです。その際、質問文をベクトル化のキーにし、回答文をコンテキストとして渡す設計にすると検索ヒット率が向上します。
貴社の情報システム部門を「問い合わせの嵐」から解放する
RAGの精度向上から、社内データの最適化まで。現場を知るコンサルタントが伴走します。
無料で戦略を相談するまとめ
RAG精度の鍵を握るチャンク分割は、単なる技術作業ではなく、社内ナレッジの「再構築」そのものです。固定長分割の限界を理解し、ドキュメントの構造や文脈を反映したセマンティックな分割を導入することで、AIは初めて「使える相棒」へと進化します。情報システム部門の負担を軽減し、全社の生産性を引き上げるために、まずは既存データの切り出し方から見直してみることをお勧めします。
公開日: 2024年10月9日 / 著者: 安田 修
あわせて読みたい
参考文献
- [1] Lewis, P., et al. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks.
- [2] OpenAI. (2024). Best practices for retrieval-augmented generation.